
Encja w SEO - czym jest i jak ją zbudować (2026)
Encja w SEO to jednoznacznie identyfikowalny obiekt - osoba, organizacja, miejsce, produkt lub pojęcie - który wyszukiwarka rozpoznaje niezależnie od użytych słów i łączy relacjami z innymi obiektami. Google opisał to w 2012 roku hasłem "things, not strings", a jego Knowledge Graph w 2020 roku obejmował ponad 500 mld faktów o 5 mld encji.

W artykule poznasz:
- definicję z patentu Google,
- rodzaje encji,
- różnicę wobec słowa kluczowego,
- dane strukturalne i sposoby sprawdzenia,
- czy Google rozpoznaje Twoją markę?
Co to jest encja według Google?
Encja według Google to "rzecz lub pojęcie, które jest pojedyncze, unikalne, dobrze zdefiniowane i rozróżnialne" - tak definiuje ją patent US10235423B2 "Ranking search results based on entity metrics", zgłoszony w 2012 i przyznany w 2019 roku. Każda encja ma atrybuty, np. datę założenia, oraz relacje z innymi encjami, np. "założyciel" albo "siedziba".
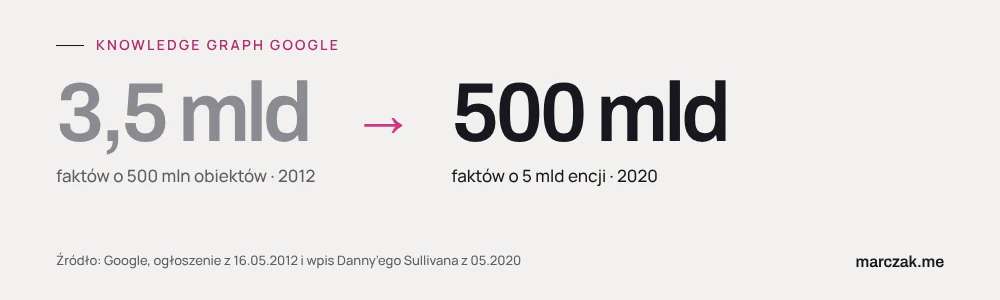
Google zbiera te fakty w Knowledge Graph. Amit Singhal ogłosił go 16 maja 2012 roku z bazą ponad 500 mln obiektów i 3,5 mld faktów. Przykładem z ogłoszenia było zapytanie "taj mahal": zabytek, muzyk, kasyno w Atlantic City albo pobliska restauracja - graf pozwala wskazać, o który obiekt chodzi.
W maju 2020 roku Danny Sullivan podał, że graf zgromadził ponad 500 mld faktów o 5 mld encji. Źródłem są treści z sieci, otwarte i licencjonowane bazy danych, a Wikipedia jest jednym z nich, nie jedynym. Ten model rozumienia treści to fundament, na którym opiera się SEO w erze AI.
Graf pozwala odpowiadać na zapytania relacyjne. Fraza "założyciel Microsoftu" prowadzi od encji "Microsoft" przez atrybut "założyciel" do encji "Bill Gates" i "Paul Allen" - nawet gdy strona nie zawiera dokładnie takiego zdania.
Jakie są rodzaje encji?
Rodzaje encji w SEO odpowiadają typom obiektów w grafie wiedzy: osoby, organizacje, miejsca, produkty, wydarzenia, dzieła i pojęcia abstrakcyjne. Knowledge Graph Search API zwraca je jako typy schema.org, np. Person, Organization czy Place. Dla firmy liczą się przede wszystkim trzy: organizacja (marka), osoby (założyciele, eksperci) oraz oferowane produkty lub usługi.
| Rodzaj encji | Typ schema.org | Przykład |
|---|---|---|
| Osoba | Person | Bill Gates |
| Organizacja | Organization | Microsoft |
| Miejsce | Place / LandmarksOrHistoricalBuildings | Taj Mahal |
| Produkt | Product | iPhone 16 |
| Usługa | Service | audyt SEO |
| Pojęcie | Thing / DefinedTerm | optymalizacja dla wyszukiwarek (Wikidata Q180711) |
Encja to nie sama nazwa, tylko zestaw atrybutów i relacji. Dla sklepu z kawą encją jest "kawa ziarnista" z atrybutami "pochodzenie", "stopień palenia" i "gatunek: arabica/robusta" oraz relacją "sprzedawana przez: [marka sklepu]".
Zacznij od listy encji, bez których Twojej oferty nie da się opisać: marka, osoby, produkty, usługi, kluczowe pojęcia branżowe. Każdej przypisz atrybuty, które klient sprawdza przed zakupem, i relacje z pozostałymi encjami z listy.
Czym encja różni się od słowa kluczowego?
Encja różni się od słowa kluczowego tym, że słowo kluczowe to ciąg znaków wpisany w wyszukiwarkę, a encja to obiekt, którego ten ciąg dotyczy. Fraza "zamek" pasuje do co najmniej dwóch encji: budowli i elementu drzwi. Jedna encja zbiera za to odmiany, nazwy alternatywne i obcojęzyczne pod jednym identyfikatorem w grafie wiedzy.
| Kryterium | Słowo kluczowe | Encja |
|---|---|---|
| Czym jest | ciąg znaków w zapytaniu | obiekt z atrybutami i relacjami |
| Wieloznaczność | jedna fraza = 2+ znaczenia ("zamek", "apple") | jedna encja = jedno znaczenie |
| Odmiana w polszczyźnie | "encja", "encji", "encję" to osobne ciągi | wszystkie formy wskazują ten sam obiekt |
| Identyfikator | brak | MID w Knowledge Graph, Q-id w Wikidata |
| Sposób optymalizacji | frazy w tytule, nagłówkach i treści | spójny opis, dane strukturalne, wzmianki zewnętrzne |
| Miara efektu | pozycja na frazę | poprawny opis marki w wynikach i odpowiedziach AI |
Słowo kluczowe to sposób, w jaki ktoś pyta; encja to temat pytania. W polszczyźnie ta różnica waży więcej niż w angielskim, bo fleksja mnoży warianty tej samej nazwy. Dlatego tekst powinien dopowiadać kontekst - pełną nazwę firmy, typ działalności, lokalizację - zamiast zakładać, że sama nazwa wystarczy.
Frazy nadal mają znaczenie: wskazują, jak użytkownicy formułują potrzeby. Encje pozwalają za to dopasować stronę do zapytań, których tekst nie zawiera dosłownie, co szczególnie pomaga przy dłuższych zapytaniach opisanych w artykule o tym, czym jest pozycjonowanie long tail.
Jak algorytmy Google rozumieją kontekst dzięki encjom?
Algorytmy Google rozumieją kontekst, łącząc encje z grafu wiedzy z modelami języka, które interpretują całe zapytanie zamiast pojedynczych słów. Kolejne etapy to Hummingbird (sierpień 2013), RankBrain (2015), neural matching (2018), BERT (2019) i MUM (2021). Encja rozstrzyga, o jaki obiekt chodzi, a model języka - jaką relację między obiektami opisuje zapytanie.
| System | Start | Co zmienił |
|---|---|---|
| Hummingbird | sierpień 2013 (ogłoszony 26.09.2013) | przebudowa systemów rankingowych, analiza całych zapytań; objął ok. 90% wyszukiwań; dziś na liście systemów wycofanych |
| RankBrain | 2015 | pierwszy system deep learning w wyszukiwarce; wiąże słowa z pojęciami |
| Neural matching | 2018 | rozumie reprezentacje pojęć w zapytaniach i na stronach |
| BERT | 25.10.2019 (angielski, USA); 9.12.2019 ponad 70 języków, w tym polski | czyta słowo w kontekście tego, co stoi przed nim i po nim |
| MUM | 18.05.2021 | według Google 1000 razy mocniejszy od BERT, trenowany na 75 językach, rozumie tekst i obrazy; nie służy do ogólnego rankingu |
Źródła: przewodnik po systemach rankingowych Google, Pandu Nayak o AI w wyszukiwarce (2022), ogłoszenie BERT (2019), ogłoszenie MUM (2021).
Przykład z ogłoszenia BERT to zapytanie "2019 brazil traveler to usa need a visa". Wcześniej Google pomijał przyimek "to" i pokazywał wyniki dla Amerykanów jadących do Brazylii; BERT zrozumiał, że chodzi o Brazylijczyka podróżującego do USA. W polskich zapytaniach tę samą rolę pełnią przyimki i końcówki: "lot z Polski do Brazylii" to inna intencja niż "lot z Brazylii do Polski".
Jak zbudować encję marki na stronie?
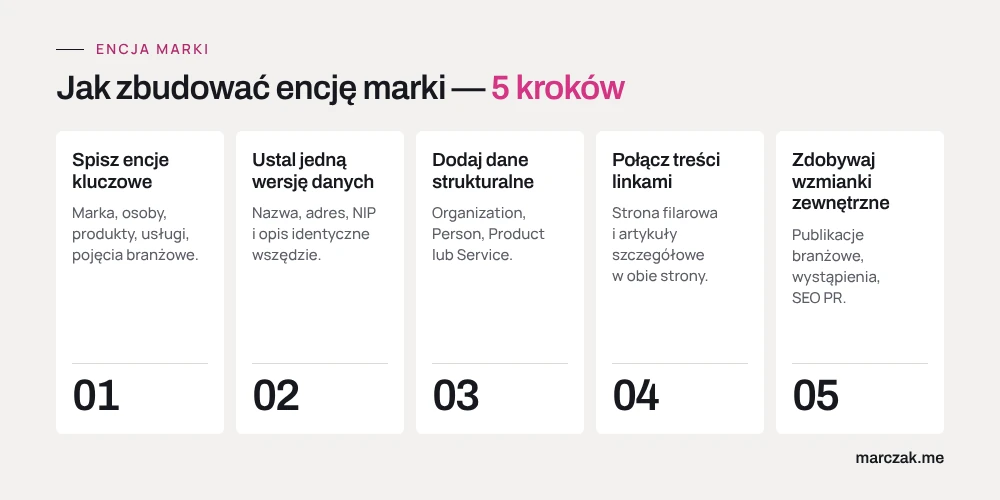
Aby zbudować encję marki, należy opisać ją identycznie w każdym miejscu: ta sama nazwa, adres, opis i kategoria na stronie, w danych strukturalnych i w profilach zewnętrznych. Dane strukturalne Organization umieszcza się na stronie głównej albo stronie z opisem firmy, a właściwość sameAs wskazuje profile potwierdzające tożsamość, np. LinkedIn lub wpis w Wikidata.
- Spisz encje kluczowe - marka, osoby, produkty, usługi, główne pojęcia branżowe.
- Ustal jedną wersję danych - nazwa, adres, telefon, NIP, opis i kategoria identyczne na stronie, w Profilu Firmy w Google, na LinkedIn i w katalogach branżowych.
- Dodaj dane strukturalne - Organization na stronie głównej, Person dla autorów i ekspertów, Product lub Service na stronach oferty.
- Połącz treści linkami - strona filarowa i artykuły szczegółowe z linkami w obie strony pokazują zakres tematu.
- Zdobywaj wzmianki zewnętrzne - publikacje branżowe, wystąpienia i SEO PR potwierdzają, że encja istnieje poza Twoją stroną.
Najczęstszy problem to rozjazd danych: inna nazwa w katalogu, stary adres na LinkedIn, skrót zamiast pełnej nazwy na stronie. Dla wyszukiwarki to sygnał, że chodzi o dwa odrębne byty. Autorzy i eksperci to osobne encje typu Person - ich biogramy, publikacje i profile wzmacniają sygnały doświadczenia opisane w artykule o E-E-A-T.
Jak opisać encje w danych strukturalnych?
Encje w danych strukturalnych opisuje się słownikiem schema.org w formacie JSON-LD: typ obiektu (np. Organization, Person), jego atrybuty oraz właściwość sameAs z adresami stron, które jednoznacznie potwierdzają tożsamość. W artykułach właściwość about wskazuje temat główny, a mentions - encje tylko wspomniane w tekście, zgodnie z definicjami schema.org.
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "Encja w SEO: czym jest i jak Google rozumie kontekst treści?",
  "datePublished": "2026-10-13",
  "dateModified": "2026-10-13",
  "author": {
    "@type": "Person",
    "name": "Jan Kowalski",
    "url": "https://example.com/autor/jan-kowalski/",
    "sameAs": ["https://www.linkedin.com/in/jan-kowalski-przyklad/"]
  },
  "publisher": {
    "@type": "Organization",
    "name": "Przykładowa Firma",
    "url": "https://example.com/",
    "sameAs": ["https://www.linkedin.com/company/przykladowa-firma/"]
  },
  "about": {
    "@type": "Thing",
    "name": "optymalizacja dla wyszukiwarek internetowych",
    "sameAs": "https://www.wikidata.org/wiki/Q180711"
  },
  "mentions": [
    {
      "@type": "Thing",
      "name": "Google Knowledge Graph",
      "sameAs": "https://en.wikipedia.org/wiki/Knowledge_Graph_(Google)"
    }
  ]
}
Google wymienia sameAs wśród zalecanych właściwości danych Organization, a w danych Article akceptuje sameAs zamiast author.url przy rozróżnianiu autorów. Właściwości about i mentions nie występują w dokumentacji Google - to słownik schema.org, który porządkuje opis tematu, ale nie daje wyniku rozszerzonego. Szczegóły typów i właściwości opisuje przewodnik po tym, jak wdrożyć dane strukturalne Schema.org.
Dane muszą zgadzać się z widoczną treścią. Wytyczne Google zabraniają oznaczania treści niewidocznych lub wprowadzających w błąd; skutkiem może być działanie ręczne, po którym strona traci prawo do wyników rozszerzonych, choć pozycje w zwykłych wynikach się nie zmieniają.
Uwaga: od 7 maja 2026 roku Google nie wyświetla wyników rozszerzonych FAQ (changelog dokumentacji). FAQPage pozostaje poprawnym typem schema.org, ale nie daje już dodatkowego wyglądu w wynikach.
Jak sprawdzić, czy Google rozpoznaje Twoją encję?
Rozpoznanie encji przez Google sprawdza się w trzech miejscach: panelu wiedzy w wynikach wyszukiwania, Knowledge Graph Search API, które zwraca identyfikator i typ schema.org encji, oraz Google Cloud Natural Language API, które mierzy salience, czyli centralność encji w tekście w skali od 0 do 1. Żadne z tych narzędzi nie pokazuje wpływu na ranking.
Knowledge Graph Search API zwraca pojedyncze encje w formacie JSON-LD. Google zastrzega, że API nie nadaje się do zastosowań krytycznych produkcyjnie, a nowym użytkownikom poleca Cloud Enterprise Knowledge Graph. Do ręcznego sprawdzenia marki wystarczy: brak wyniku oznacza, że graf nie ma jeszcze takiej encji.
Cloud Natural Language API przypisuje encjom w tekście salience oraz, gdy są dostępne, MID z grafu wiedzy i adres Wikipedii. Ograniczenie: analiza encji nie obsługuje języka polskiego - obejmuje 11 wariantów językowych, m.in. angielski, niemiecki, francuski i hiszpański. Polskie teksty da się sprawdzić tylko pośrednio, np. na wersji angielskiej.
Raz w miesiącu zapytaj ChatGPT, Perplexity i Gemini o swoją markę i zapisz, czy opis jest poprawny i które źródła są cytowane. Jeśli opis jest błędny albo marki brakuje w odpowiedziach, to sygnał do pracy nad widocznością marki w AI. W Google Search Console obserwuj zapytania z nazwą marki, a raz na kwartał sprawdź spójność danych.
Podsumowanie
Encja w SEO to obiekt, który Google identyfikuje niezależnie od słów - osoba, firma, miejsce, produkt lub pojęcie - i łączy relacjami w Knowledge Graph. Dla firmy oznacza to spójne dane marki w każdym miejscu, dane strukturalne Organization i Person z właściwością sameAs, treść zgodną ze znacznikami oraz wzmianki w niezależnych źródłach. Sprawdzaj efekt w panelu wiedzy, Knowledge Graph Search API i odpowiedziach narzędzi AI.
Najczęściej zadawane pytania o encje w SEO
Czy każda firma może stać się encją w Google?
Czy można pozycjonować stronę bez budowania encji?
Czym jest Wikidata i czy warto dodać do niej firmę?
Co oznacza salience encji?
Czy schema FAQPage nadal pomaga w Google?


